机器之心发布
11 月 9 日,Anthropic 发布 Claude Fable 5.2。据报道,它在机器人控制基准 RoboDojo 上拿到 64.9% 的成绩,是上一代 Fable 5.1(27.6%)的两倍多。而就在两个月前,GPT-6 Astra 刚以 22.48% 的平均成功率登顶这一榜单,超过全部 40 个公开策略。
通用大模型的具身能力正以惊人的速度提升,但榜单上的分数,还不等于真实世界里的能力。在一项联合研究 [1] 中,GPT-6 Astra 被部署到 8 种真机配置上:插插头 11 次尝试全部失败,长程导航找物 23 次尝试中仅成功 9 次。研究者的判断是,它已具备初步的具身能力,但距离实用仍有差距。
如何让通用大模型更好地控制机器人,在真实环境中连续完成更长、更复杂的任务?模型既需要可供学习的行为示范,也需要能执行任务、积累经验的环境。大模型有 Scaling Law,物理智能的 Scaling Law 又在哪里?要回答这个问题,首先得弄清楚:该扩展怎样的环境与行为数据,又该如何持续生产和使用?
近日,Physical AI 初创公司 Ropedia 正式发布 Xperience 2,给出了自己的答案:Ropedia Xperience 2 是一套面向 Physical AI 的真实环境与行为数据集,它将真实场景扫描与人的第一视角活动记录相结合,在同一度量坐标系中对齐场景几何、录像、轨迹和身体姿态。
基于这些数据,Ropedia 将人的动作转换为机器人轨迹,并将扫描场景转换为可交互的仿真环境。Ropedia 希望以这种真实采集、精准对齐、覆盖多样且可复用的环境 - 行为一体化数据,建立下一代具身数据的 “金标准”,为后 GPT-6 时代物理智能在环境与行为数据上的规模定律奠定数据基础。
技术报告:Ropedia Xperience 2: A Gold Standard for Scaling Physical AI Environments and Behaviors
报告链接:https://arxiv.org/abs/2611.17060
项目主页:https://ropedia.com/xperience/2-research
数据集:https://huggingface.co/datasets/ropedia-ai/Ropedia-Xperience-2
 1,812 个场景组成 Xperience 的 X。
物理智能的「金标准」数据:环境与行为,缺一不可
扫描、记录与对齐:让每个行为有真实环境参照
Xperience 2 为每段任务录像保留对应的场景重建。视频中的相机轨迹、手部和全身动作被放进同一个三维坐标系,与房间的几何和布局对齐。使用者可以回看人怎样在这个房间里行动,也可以继续利用这些记录构建机器人任务。
以把杯子放进橱柜为例,视频能记录取杯、开门、放入和关门的过程,供模型学习动作和顺序。机器人真正做这件事时,还需要知道杯子在哪里、柜门朝哪边开、自己的手臂能否够到,以及怎样判断任务完成。这些信息需要结合场景的几何和物体状态来确定。光有录像,机器人还没有一个能试做这项任务的环境。
而只有仿真场景,同样不够。仿真场景让机器人有了练习的地方,人的示范则能提供起步的方法。缺少示范时,抓杯子的位置、开柜门的方向和放杯子的动作都可能需要反复探索,还要设计相应的奖励。任务步骤越多,这样训练的成本往往越高。
现有数据集通常侧重其中一类。ScanNet++、Realsee3D 和 DL3DV-10K 提供三维场景重建和相机位姿,没有对应的人类第一视角任务录像;EPIC Fields、Nymeria 和 HD-EPIC 记录了人的活动和相机位姿,但大多不提供场景网格。
Xperience 2 把场景和人的示范放在一起。两者对齐后,人的动作有了明确的空间参照,可以根据机器人的身体结构转换成运动轨迹,再放回同一场景中检查。原始录像由此可以继续用于机器人的动作研究。
场景完成交互配置后,还可以设定杯子的位置、柜门状态和机器人起点,让机器人在里面执行任务。没抓住杯子、把杯子放在柜子边缘,或者忘了关门,都能根据物体状态判定并记录。失败后重新加载场景,就能再试一次;换一组初始条件,还可以继续采集新的轨迹。

录像与场景对齐后的各层数据:网格、3DGS、第一视角视频、头部轨迹、双手和全身姿态,以及三个时间尺度的活动标注,位于同一个度量坐标系中。
这套采集延续了 Ropedia 在第一视角数据上的积累。此前的 Xperience-10M 包含约 1,000 万个真实世界交互片段、1 万小时第一视角视频与音频。Xperience 2 在这些行为记录之外增加了场景扫描与空间对齐,让每段活动都有对应的真实环境。同一次扫描可以供这个场景中的多段任务录像使用。
两步采集使用不同的设备。手持激光雷达扫描仪可以从不同角度扫描房间,补充人的视角不容易覆盖的区域。录制任务时,操作员戴上 Ropedia 研发的头戴式记录仪 HOMIE Headset 2,双手可以自由操作物体。HOMIE Headset 2 的四路全局快门鱼眼相机、惯性传感器和四声道音频一起记录活动,其中两路朝前的相机拍摄双手和正在操作的物体。整套采集不依赖固定动捕设施,可以进入住宅、餐厅、商店、办公室和户外。

先扫描场景,再逐项录制任务。左侧为两个步骤;右侧依次出现扫描仪的路线与相机位姿、场景重建,以及各段 HOMIE Headset 2 录像的头部轨迹。
操作员先从多个角度扫描房间,得到带真实尺度的场景网格、三维高斯重建(3DGS)以及对应的图像、相机位姿和稀疏点云。这些数据共用一个与重力对齐的坐标系。后续再为物体配置物理属性和可交互部件,场景就能用于仿真。
扫描结束后,操作员戴上 HOMIE Headset 2,逐项完成分配给这个场景的任务。每段录像从任务开始前录到完成后,保留一次完整的活动过程。
录好的视频随后经过自动化处理,得到相机运动轨迹、深度,以及估计的双手和全身姿态。视频、惯性测量和音频按时间对齐,动作则配上三层语言标注:整段在做什么、各个子任务何时发生,以及具体画面里物体和双手处于什么状态。
 同一场景中不同时刻的估计全身姿态、轨迹和对应的第一视角画面;下方列出每段录像提供的各层数据。
接下来,把录像和扫描对齐。系统先找出录像画面在扫描场景中的位置,再把相机轨迹、双手和全身动作变换到场景坐标系中。配准后会检查留出的验证帧、重力方向和深度与网格是否吻合,并为每段录像标记 PASS、WEAK 或 FAIL,便于使用者筛选。
 录像配准:录像先出现在它自己的坐标系中,再配准到场景坐标系;右上角的卡片列出三项检查,全部通过后标记为 PASS。
处理后的轨迹和姿态与原始画面一同保留,使用者可以回看视频,检查某段动作是否适合自己的训练任务。
从卧室到街头:把真实世界的多样性搬进数据
从卧室和厨房,到办公室、商店和街头,当前发布的 1,589 个场景覆盖 12 类真实空间。其中住宅内部场景有 1,389 个,占 87.4%;卧室和客厅合计 976 个,占 61.4%。整体采集共覆盖 596 处地点,其中 443 处为整户住宅。地点数量采用整体采集统计,与本次发布的场景数量分别计算。
按整体任务采集统计,共记录 74 项任务、4,230 段录像,覆盖取放、清洁、整理、折叠和检查五类活动。按主要动词划分,共有七种动作,其中放入或取出物体有 25 项,擦拭清洁有 23 项,摆放整理有 18 项。74 项任务中,31 项来自餐厅、商店和办公室等工作与零售场景。

高精度数据:让模型的空间能力可以被检验
机器人进入一个陌生房间,要恢复周围的三维结构、找到物体,并理解距离与方向。Xperience 2 围绕这三类能力,在同一组 20 个真实扫描场景上构建了三项 Benchmark。扫描几何、相机位姿与空间标注提供了参照,让模型在真实环境中的能力可以被具体检查。
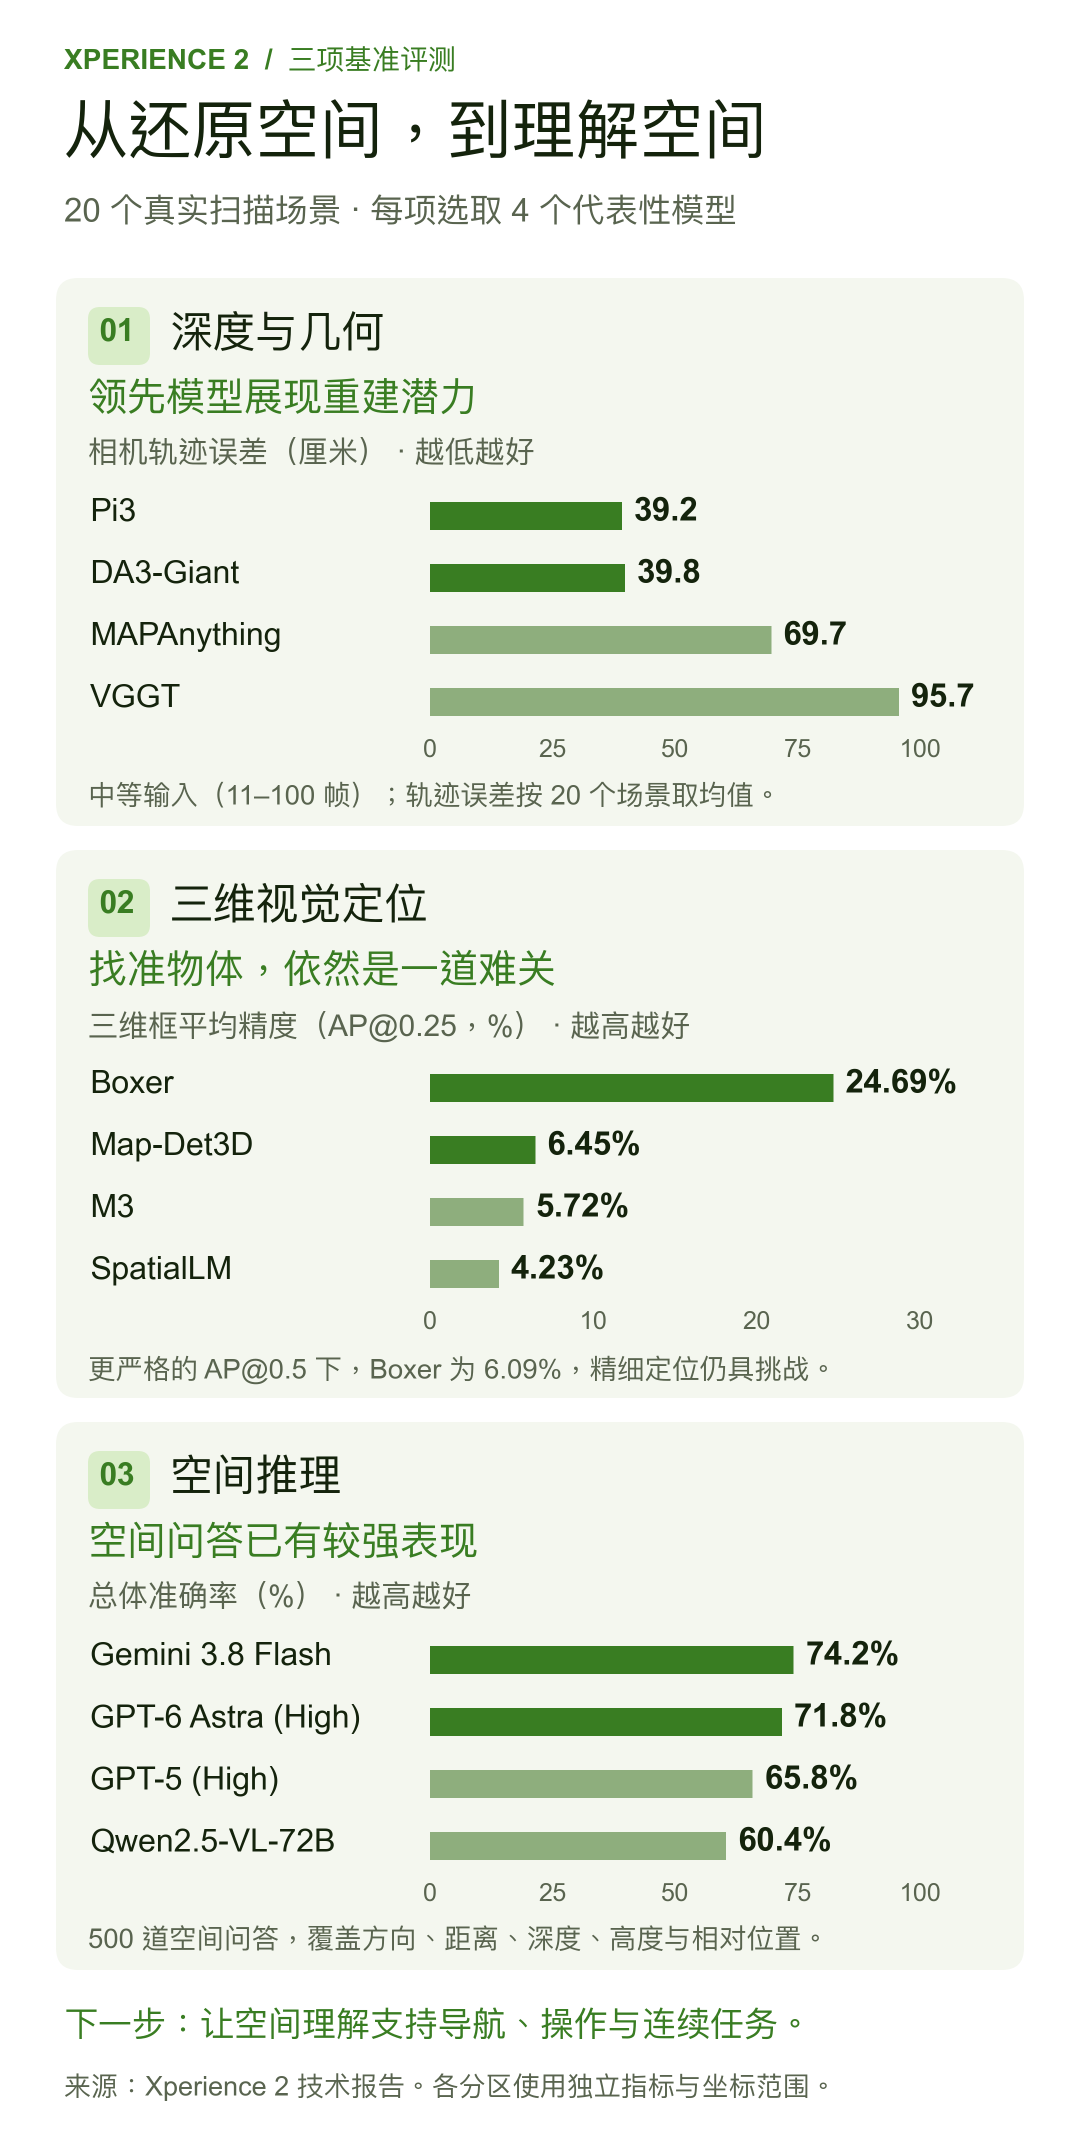
三项基准的代表性模型对比,每项展示 4 个模型。相机轨迹误差越低越好,物体定位精度与空间问答准确率越高越好。几何评测采用中等输入(11–100 帧)。
还原空间:领先模型展现重建潜力
从图像恢复房间,需要同时恢复场景表面与相机的运动。在 11 个模型的比较中,π³ 在三档输入下的轨迹误差最低、表面重建 F 值最高;DA3-Giant 则在中等与稠密输入下的位姿恢复表现领先。有了扫描几何和相机位姿作为参照,深度、轨迹与表面重建中的误差就能被分别衡量。更丰富的真实场景,也能让后续训练与评测覆盖更多布局和观察条件。
找准物体:真实环境仍是一道难关
恢复了房间的结构,还要确定物体的位置。这项评测要求模型识别目标、预测三维框。表现最好的 Boxer,AP@0.25 为 24.69%,在更严格的 AP@0.5 上为 6.09%。真实环境中的精确定位仍然困难,也凸显了更多开放真实场景数据的需求:让训练与评测覆盖更广泛的布局、遮挡和物体差异,并为模型提供可靠的三维标注。
理解空间:空间问答已有较强表现
空间推理基准包含 500 道题,覆盖平移、旋转、距离、深度、高度和相对位置。Gemini 3.8 Flash 的总体准确率为 74.2%,GPT-6 Astra(High)为 71.8%。在高度与相对位置判断上,两者的准确率都超过 90%,已经能较好地回答多类空间问题。
下一步,是让这些空间理解支持实际行动。 模型需要把对位置、方向和物体关系的判断,用于导航、操作以及连续完成长时程任务。Xperience 2 将真实环境与人的行为对应起来,为模型学习 “在这样的空间里,怎样把任务做完” 提供数据基础。
从真实场景到虚拟训练场:拓展机器人经验生成路径
同一批真实场景和人类活动,可以用于不同类型的机器人数据生产。技术报告介绍了四种用法:Real-to-Sim 把扫描场景转成可交互的仿真环境;人体动作重定向把人的示范转成机器人运动参考;虚拟遥操作在仿真中采集新的交互;长时程轨迹生成则用程序连续完成多步任务,产出完整轨迹。
一次真实采集留下的场景和录像,可以在这些过程中反复使用。新的机器人动作与交互记录,则在原始录像之外继续增加。

四项演示的数据来源、收益与每次采集的成本,以真机遥操作为参照。方块为技术报告中的定性评分,不是测量值。
Real-to-Sim:构建可交互的任务环境
Real-to-Sim 使用场景扫描得到的几何和外观,先把物体逐个重建出来,再加入碰撞、关节和物理属性,让它们能在仿真中被操作。在一个真实住宅的演示中,团队转换得到了 107 个物体,其中 73 个可以交互。
转换后的场景沿用扫描的尺度和坐标,可以与扫描重建从同一个相机视角渲染,再逐像素检查差别。在图示视角中,仿真表面与扫描网格之间的距离中位数约为 2.5 厘米,约 79% 的像素距离不超过 5 厘米。

Real-to-Sim 第一部分,物体的重建。上:同一相机下的扫描重建、两者的逐像素距离和仿真场景;下:转换后按物理类型标出的物体三维框。
团队还在另一处住宅做了对照:让 GPT-6 Astra 只根据采集的图像搭建场景,不提供 3DGS。结果中,物体的颜色、尺寸和位置都出现了偏差;电视、冰箱、微波炉和水壶的三维框,也偏离了它们在 3DGS 中的位置。这个对照以 3DGS 为参照,比较的是两种场景与扫描重建的一致程度。

另一个住宅场景中,同一视角下的 3DGS、GPT-6 Astra 仅凭图像构建的场景和 Real-to-Sim 场景。三维框标出四个匹配物体,衡量与 3DGS 的一致性,并非独立真值。
物体独立建模后,就可以按任务配置它们的行为。演示中的 73 个可交互物体包括 9 个铰接物体,如冰箱门、柜门和抽屉;8 个用有限元方法模拟的软体,如靠垫;以及 4 块布料,如电视罩布和毛巾。开关和遥控器按键可以按下,水龙头可以出水,下图中的七种交互都来自同一次物理仿真。
以收杯子为例,杯子、柜体和柜门分别建模后,才能配置开门、放杯子和关门。配置好的场景可以反复加载,也可以换任务、改起点。同一次真实扫描,因此可以继续用于多轮机器人实验。

Real-to-Sim 第二部分,物体的仿真交互。七个交互都来自同一次物理仿真。
Action Retargeting:为机器人提供人类示范的动作起点
人体动作重定向使用已经对齐到场景的人体与手部动作。人一边转身一边伸手,轮式人形机器人可能需要同时移动底盘、转动躯干、调整手臂和灵巧手。系统结合机器人的结构和运动限制,计算各部分的轨迹,再放回扫描场景中回放。这样,一段人的任务录像就能继续用于机器人的动作研究,现场不需要机器人。
轨迹还要经过速度、力矩、稳定性和碰撞检查:关节速度和力矩不超过上限的 90%,零力矩点保持在支撑多边形内,同时避免与场景或机器人自身发生碰撞。头部和指尖的跟踪误差也会被记录。

人体动作重定向:HOMIE Headset 2 录像中操作员的动作(蓝色人体)转换为轮式人形机器人的动作,在扫描的 3DGS 中回放。
演示选用了同一场景中的 4 段完整录像,分别是放快递并操作空调遥控器、洗衣服、收拾碗碟、叠毛巾并扫地,原始时长合计 10.3 分钟。录像放慢到 0.5 倍速后进行重定向,机器人底盘共行驶 96 米,各段录像中有 35%–41% 的帧处于移动状态。
四段轨迹的指尖跟踪误差中位数为 0.40–0.55 厘米,95 分位误差都低于 2 厘米。所有帧均通过约束检查,关节速度和力矩的峰值分别为上限的 90% 和 89%,零力矩点距离支撑多边形边界至少 0.46 厘米。

同一场景中 4 段录像的重定向结果,标注为各段指尖误差的中位数。橙色为操作员的手部关键点,灰色为机器人。
这一步得到的是机器人的运动参考。回放发生在 3DGS 场景中,物体不会随动作移动;机器人能否真正抓住杯子、把它稳定放进柜子,还要放进可交互的仿真环境里验证。
虚拟遥操作:在环境中采集新的交互经验
虚拟遥操作把操作员接入转换后的仿真场景。人实时控制机器人,物体会随动作发生变化,系统记录机器人的观察和控制指令,并检查指令跟踪、碰撞和关节限位。抓空之后,操作员要根据当前情况继续调整,后面的动作也会随之改变。
每轮结束后,重新加载场景就能复位,继续采集下一次示范。同一个环境可以录下多次执行、不同起始状态以及失败后的调整。这种方式仍然需要操作员,但省去了把实体机器人搬到现场和人工复位的工作。
Code-as-Policy 长程轨迹生成:让机器人经验持续扩展
任务变长后,机器人还要接着前一步的结果往下做。杯子已经放进微波炉,就要从炉内取出;取出后还要关门,再继续后面的任务。商汤牵头的联合研究中,持续跟踪多个子任务的进度,仍然是 GPT-6 Astra 的难点。[3]
团队在前面的 Real-to-Sim 住宅场景里设置了一项八步任务:轮式双臂机器人从厨房台面拿起杯子,打开微波炉,放入杯子,关门加热,取出杯子,再次关门,推开卧室门,最后把杯子放到床头柜上。机器人需要一路从厨房走到卧室,完成沿途的操作,中途不重置场景。
这次演示由策略程序完成各个子任务,通过全身控制器执行动作。程序只从感知输入中观察物体,不读取仿真器里的物体状态。改变机器人和杯子的初始位姿,同一套程序就可以生成不同起点的完整轨迹。
 长时程轨迹生成中的一次执行(16 倍速):轮式双臂机器人在由真实住宅扫描转换的仿真场景中连续完成八个子任务。
在 30 个预留初始状态下,机器人和杯子的位置各不相同,30 次执行都完成了全部八步,也都通过了任务规则检查。验收由仿真器中的物体状态决定,包括杯子不能倾倒或掉落,以及电器和门是否处于要求的状态。
每条轨迹有 3,869–4,255 个 30 Hz 控制步,平均对应 2.2 分钟仿真时间。单个仿真进程生成一条轨迹需要 10–16 分钟。场景和程序准备好后,可以继续改变初始状态、增加计算资源来生成轨迹,无需重新采集人类录像。
 同一次执行中各子任务完成时的画面与用时;从 30 个预留初始状态出发的执行全部完成八个子任务。
这 30 条轨迹来自同一个场景、同一项任务和同一套策略程序,增加的是不同初始条件下的完整执行经验。场景、机器人和任务规则准备好后,可以继续生成轨迹,用于后续数据生产与模型研究。环境覆盖和行为经验也可以据此分别记录和扩展。
成本与规模扩展:让更多环境承载更多行为
真机采集需要持续投入设备、人手和时间。DROID 在 564 个场景中采集了 350 小时机器人演示,投入了 50 名操作员和 12 个月时间。[4] 机器人要运到现场,操作员要全程控制,每轮结束后还要人工复位。
Ropedia Xperience 2 把其中一部分工作提前到了场景扫描、转换和任务配置。场景建好后可以反复加载,录像中的动作可以继续重定向,虚拟遥操作则省去了实体机器人和人工复位。同一次采集的场景和行为记录,可以在这些用法中继续发挥作用。
长时程轨迹生成则主要消耗算力。按演示中每条轨迹 10–16 分钟计算,单个仿真进程连续运行一天,理论上可以生成 90–144 条轨迹。仿真数据与真机数据的保真度不同,这几条路径可以补充真机采集,实际效果仍需通过真机实验检验。
采集地点也更灵活。操作员带着扫描仪和 HOMIE Headset 2 就能到现场,不必先把机器人运进去。多房间扫描还能保留房间之间的布局,让机器人在仿真里边走边操作。前面的八步任务就从厨房延伸到了卧室,生成的任务和轨迹也不必局限于原始录像。
从第一代到第二代 Xperience 数据集:让数据规模真正转化为物理智能
从今年早些时候发布的 Xperience-10M 到现在的 Xperience 2,Ropedia 走的是一条清晰的路线:先把人在真实世界中的行为规模化地记录下来,再把这些行为放回它们发生的真实空间,最后让环境与行为一起,变成机器人可以学习、练习和验证的数据。
大模型的进步,建立在互联网规模的文本之上;物理智能的进步,同样需要一个足够大、足够真实、能够持续扩展的数据基础。当通用模型在仿真中的能力不断刷新纪录,真正的瓶颈正在转向真实世界的环境与经验。Ropedia 希望以 Xperience 2 为起点,建立后 GPT-6 时代物理智能的环境与行为规模定律,让「数据规模如何转化为模型能力」这个问题,在物理世界中也能被测量、被检验,并最终被回答。
参考资料
[1] An Unexpected Robot Policy: Early Evaluations of GPT-6 Astra on RoboDojo and Beyond
[2] Systematically Exploring the Capabilities of GPT-6 Astra as Embodied Policies
[3] Has GPT-6-Astra Achieved Embodied Intelligence?
[4] Khazatsky et al. DROID: A Large-Scale In-the-Wild Robot Manipulation Dataset. RSS 2024.
[5] 机器之心:《Physical AI 正进入经验工程时代,Ropedia 聚焦全链路数据基建,完成数千万美元融资》,2026 年 8 月 6 日。
[6] 技术报告:Ropedia Xperience 2: A Gold Standard for Scaling Physical AI Environments and Behaviors(链接待补)
“掌”握科技鲜闻 (微信搜索techsina或扫描左侧二维码关注)