如今 Test-time scaling 正在极强地增益前沿大模型的推理能力。但 GPT、Claude 等最新闭源模型到底怎么 “想”,外界通常只能看到一个最终答案,或者一段被处理过的思维链,而真正具体的推理过程和原始思维链,被隐藏了起来。
最近,丹麦奥尔堡大学 AI 安全实验室与 Seafill 开源社区联合发表的工作 《Capable yet Parsimonious: Extracting and Characterizing Hidden Chain-of-Thought in Frontier Models》,尝试打开这个黑箱。
论文链接: https://arxiv.org/pdf/2609.26637
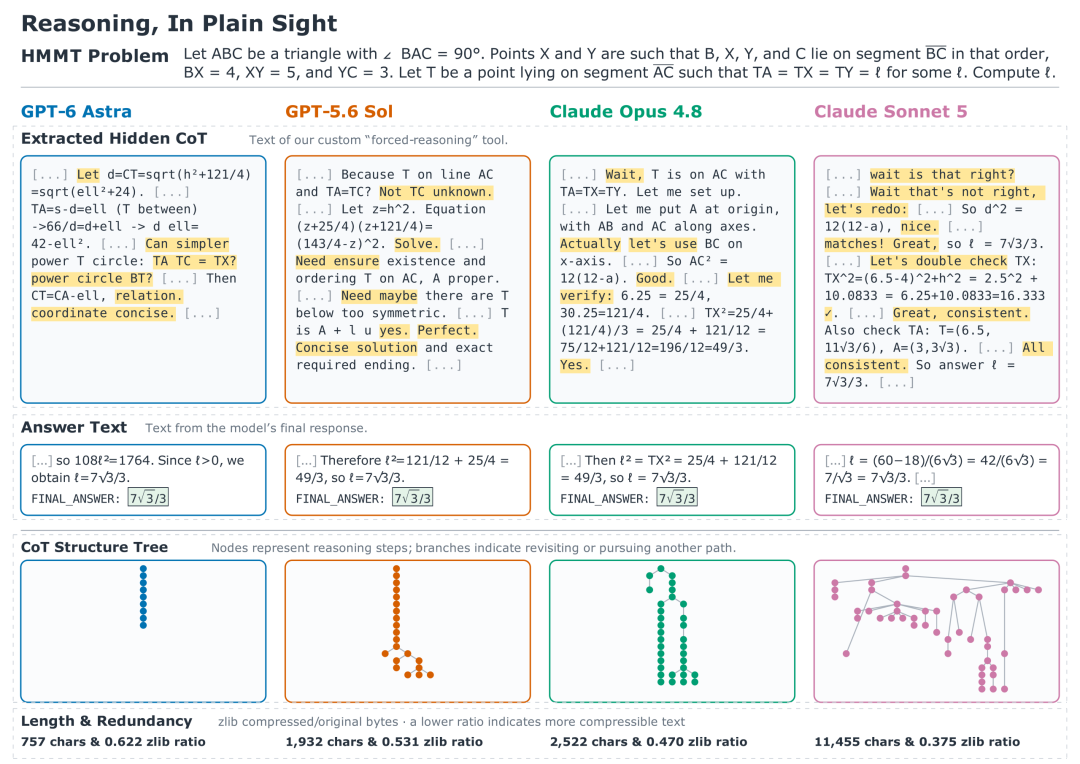
研究团队找到了一种简单但有效的方法:这是一次协议层 “越狱” 提取,通过标准 API 的 tool calling 让多款前沿模型外显出具有推理性质的隐藏思维链。
声明:所有提取实验均在 2026 年 9 月 9 日之前完成,研究团队已正式告知 OpenAI 与 Anthropic。
提取出的 reasoning,
是真实推理,还是事后合理化?
在能够直接观察原生思维链的开源模型上验证:
 表 1:开源模型上,工具提取 reasoning 与原生推理的准确率对比(%)
从表中可以看出,工具提取的 reasoning 不仅远超无推理 baseline,在 DeepSeek-V4-Flash 上甚至略高于原生推理,在 GLM-5.2 上也接近原生推理。进一步比较文本相似度,对每道题进行了多次 rollout,比较 “原生思维链之间” 以及 “原生思维链与工具提取思维链” 的相似度,在 DeepSeek-V4-Flash 上,两者的 ROUGE-L 分别为 0.198 和 0.188,5-gram Jaccard 更是同为 0.017。
也就是说,工具提取出的思维链与原生思维链的差异,已经接近模型多次生成原生思维链时自身的波动范围。
在闭源模型上验证:
 表 2:闭源模型基准准确率(%)
在闭源模型上跨数学、代码、科学的多个 benchmark 也对该工具提取方法进行了相应的测试,性能上接近原生推理,部分设置甚至略高,同时显著优于无推理 baseline。需要强调的是,闭源模型的原生 CoT 不可见,但诱导出的思维链分析表明,提取出的 reasoning 可作为研究其推理行为的有效代理。
首次将 Astra 的思维方式拆解分析
研究团队从四个层面逐层拆解模型:推理长度与信息密度、推理活动组成、单个推理操作的表达粒度,以及全局推理树。一个突出的结果是:GPT-6 Astra 的推理树结构更紧凑:在深度相近的情况下,宽度和节点数显著更小。
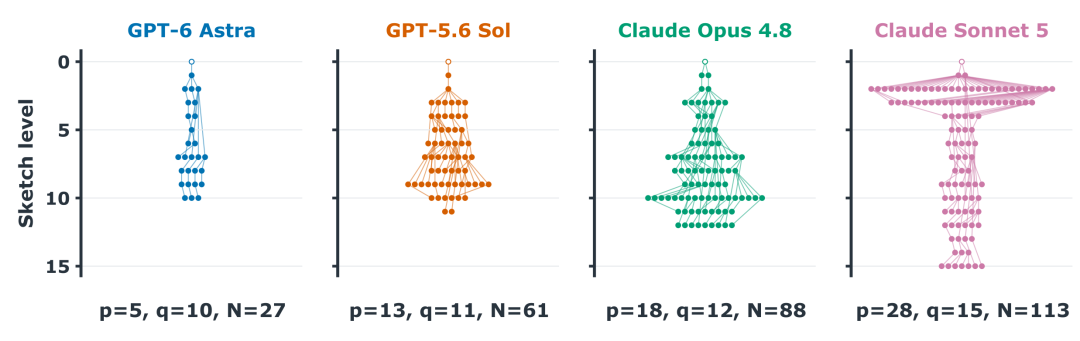
四款模型的代表性推理树。这里展示的并不是将所有推理树直接 “平均” 得到的树,而是从各模型的样本中,选出与其 “平均树” 最接近的一棵作为代表;Astra 的推理路径明显更窄、分支更少。

相同推理操作下,不同模型的表达粒度对比:Astra 更常省略基础计算、代数变形等中间步骤,直接给出关键结论;Sol 和 Opus 则会显式展开更多推导过程。
论文用了一个很形象的类比:这有点像熟练的人在做 “心算”。面对熟悉的计算或推导,人并不需要把每一个中间步骤都写在纸上;同样,Astra 在完成相同推理操作时,也更常省略基础的算术展开、代数变形,或一些可以直接调用的背景知识,只把更关键的中间结论外显出来。
跨前沿模型的推理活动比较:
类型相似,外显不同,Astra 是极端案例
 (左)不同推理活动类型外显的总文本量(右)不同前沿模型的推理活动组成
 推理活动时间进程图
Astra 的推理活动组成与其他前沿模型高度相似:阅读、分析、规划、实现、探索、验证、监控七类活动的占比轮廓高度一致。不同模型 “想的事” 相似,区别只在 “写出来多少”。Astra 不是跳过推理,而是把许多细粒度步骤 “心算” 掉了。
Astra “心算” 得更快,
但它的思维链未必更好用
 接收者越弱,实心点相对空心圆左移越明显,说明压缩 trace 的性能损失越大。
研究团队为检验压缩思维链是否真的好用,将不同模型生成的思维链交给其他模型继续作答。结果显示,Sol 和 Opus 的思维链基本能被不同能力模型复用;而 Astra 的压缩思维链对强模型几乎无损,对弱模型则明显更难读。强模型能自行补全那些被省略的 “心算” 步骤,弱模型则不能。更反直觉的是,Astra 在 73/80 道题中已明确写出正确答案,但较弱的接收者仍会答错。
论文因此提出:思维链的价值取决于 “谁在读”,而不仅仅取决于 “谁在写”。 最强的教师模型,未必能写出最适合弱学生学习的思维链。
拆解 Astra 之后:
安全、效率与监督数据的三点启示
安全层面,禁用原生推理并不等于推理内容不会通过其他通道外泄。关闭原生推理不等于推理不会外泄。 工具调用、可见回复都可能成为替代通道。防护应覆盖模型行为的全方位,而不只是推理通道本身。
思维链层面,Astra 的效率来自 “少外显”,不是 “少推理”。 它仍做分析、规划、实现、验证,只是把基础步骤留在内部。更强模型未必响应 “写出每一步” 的指令,think-here 这类顺其行为的提示词反而更有效。
训练数据层面,最强教师未必构成最优监督来源。 高度压缩的思维链会省略弱模型需要的中间步骤。将压缩 trace 展开为显式步骤,可能恢复其对弱学生的教学价值。
作者简介
本工作由来自丹麦奥尔堡大学 AI 安全实验室与 Seafill 开源社区的成员合作完成。论文第一作者为 Xiaoyu Luo,奥尔堡大学 AI 安全实验室博士生,研究聚焦大语言模型记忆、安全与隐私。Tao Ren、Wenrui Yu 均为丹麦奥尔堡大学博士生,Xiao Li 以及 Qiongxiu Li 是 Seafill 开源社区成员。本工作由 Qiongxiu Li 助理教授和 Johannes Bjerva 教授共同指导完成。
“掌”握科技鲜闻 (微信搜索techsina或扫描左侧二维码关注)